达光PDF
PDF OCR
关于PDF OCR
使扫描件文本可搜索
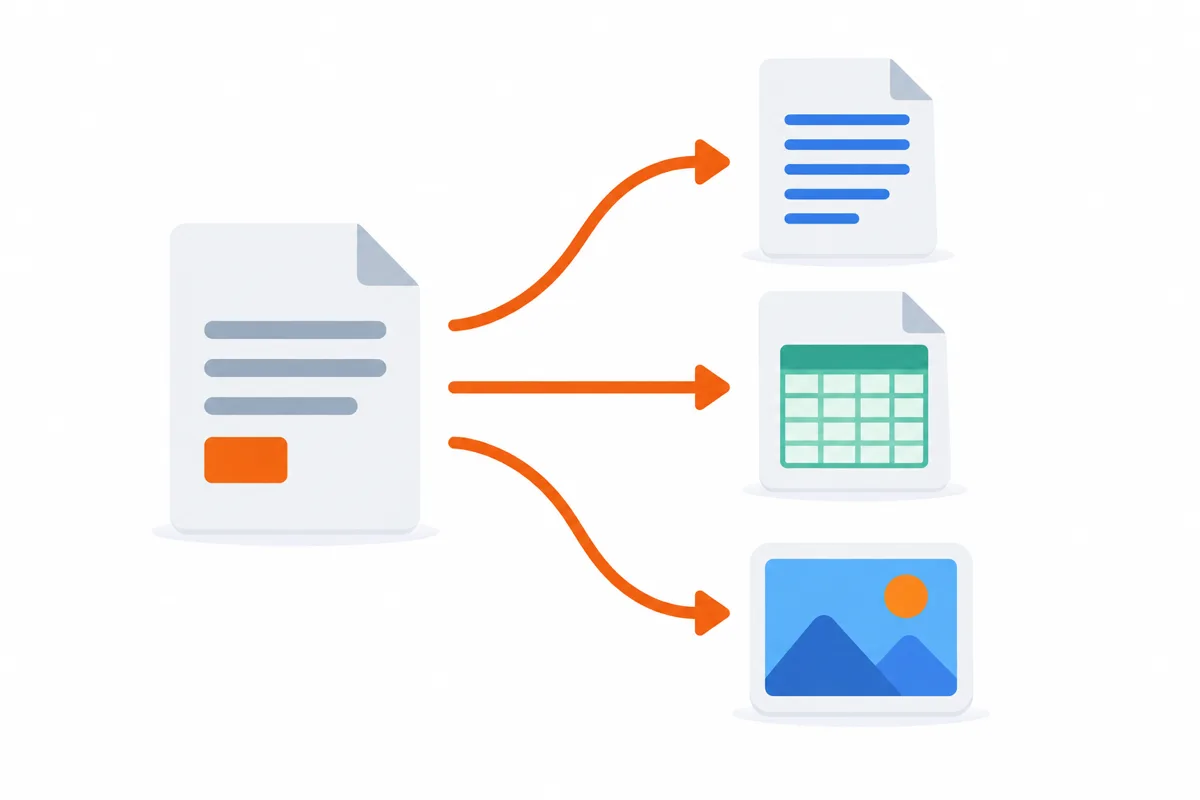
PDF OCR通过光学字符识别把扫描件、图片型PDF中的文字转换为可选中、可搜索、可批注的文本层,中英文混排均可识别。
识别完成后原文页面保持原样,仅叠加不可见文本层,便于复制引用与全文检索。
扫描仪和手机拍出来的PDF里,文字只是像素,既搜不到也选不中,归档之后只能一页页翻找。PDF OCR要解决的就是把这种"看得见却抓不到"的内容恢复成可检索的数据,同时不拆散原始版面,适合必须保持原貌、又需要全文检索的合同、公文与旧档案。
做法上先做版面分析,把页面划成文字块、表格与图片区域,再对文字块逐行识别字符,并用上下文对置信度低的字做校正,最后按每个字在原图上的位置,把它们作为一层不可见文本叠回页面。所以排版与观感不变,却多了可选中、可搜索的文字。
效果取决于原图能提供多少信息。分辨率不足、页面倾斜、有摩尔纹或印章压字时,笔画粘连会让字与字切分出错;手写体、竖排古籍、超小字号以及带表格线的版面,阅读顺序与单元格归属也容易错位。文本层只解决检索与复制,不重排版面,复制出来的文字可能夹带多余换行。
输入PDF输出PDF(含可搜索文本层)免费使用无需注册
- 仅支持PDF文件(单个最大 25 MB)
- 扫描件建议 300 DPI及以上,识别更准确
功能亮点
扫描件变可搜索
光学字符识别把图片型PDF变成可选中、可搜索的文本层
中英文混排
中文、英文与混排内容均可识别
原文保持原样
只叠加不可见文本层,页面外观不变
免费且无需注册
打开页面即可识别扫描件,免注册,也不要求留联系方式
多端浏览器可用
手机拍完就能在手机浏览器里识别,不用另装软件
加密传输 · 服务器限时删除
扫描件经HTTPS加密上传,识别完由服务器限时自动删除
如何识别PDF文字
- 1
上传扫描件
仅支持PDF,单个最大 25 MB;建议 300 DPI及以上,识别更准确。
- 2
开始识别
对整份文档执行光学字符识别。
- 3
等待完成
原文页面保持原样,识别结果叠加为不可见文本层。
- 4
下载使用
转出后即可全文搜索、复制引用与批注。
适用场景
纸质档案数字化
扫描的合同、卷宗建库后可全文检索
复制引用文字
扫描资料里的段落可直接复制粘贴
全文检索
几百页的扫描册子也能秒搜关键词
学习资料整理
扫描讲义、真题变成可搜索笔记
PDF OCR常见问题
清晰的电子扫描件(300 DPI及以上)识别效果好;模糊、手写或倾斜严重的页面精度会下降,建议先优化扫描质量。